Architecture hexagonale : le métier reste testable quand l’infrastructure change
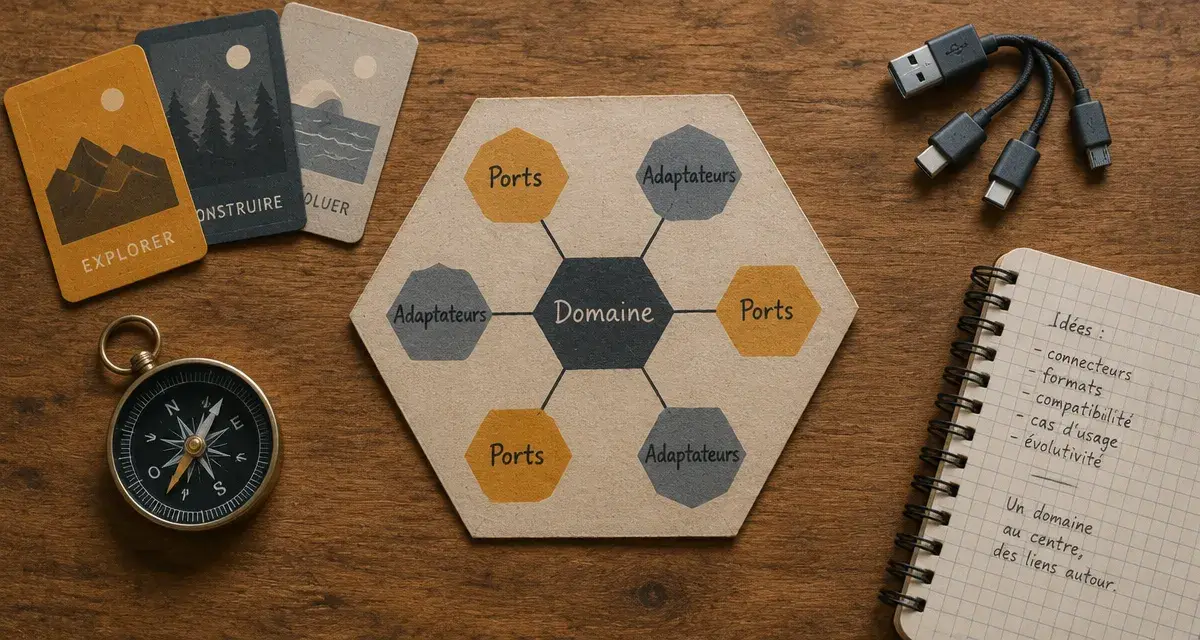
L’architecture hexagonale place la logique métier au centre de l’application et les détails techniques à sa périphérie. Son objectif n’est pas de dessiner un hexagone parfait, mais de rendre le cœur fonctionnel utilisable et testable sans dépendre directement d’une base de données, d’une interface web, d’un framework ou d’un service tiers. Lorsqu’un projet doit évoluer, cette séparation limite la propagation des changements techniques dans le métier.
Pourquoi l’architecture hexagonale change le sens des dépendances
Proposée par Alistair Cockburn en 2005, l’architecture hexagonale est aussi appelée architecture ports et adaptateurs. Elle répond à un problème courant : dans de nombreuses applications, le code métier finit par connaître le contrôleur REST, l’ORM, les tables SQL, les messages d’erreur d’un fournisseur de paiement ou les détails d’un framework. Le métier devient alors plus difficile à comprendre, à tester et à modifier.
Le principe central est simple : le domaine ne dépend pas de l’infrastructure. Les dépendances doivent pointer vers le cœur de l’application, et non vers les détails externes. Une base PostgreSQL, une API GraphQL ou une interface mobile deviennent des moyens d’interagir avec le métier. Elles ne définissent plus sa structure.
L’hexagone est une métaphore, pas une structure de dossiers
Les six côtés de l’hexagone ne correspondent ni à six couches ni à six modules obligatoires. L’image représente la possibilité de connecter plusieurs acteurs externes au même noyau : un utilisateur via une interface web, un traitement planifié, un terminal de commande, une API REST ou un consommateur de messages. L’application peut aussi s’appuyer sur une base de données, un outil de notification, un moteur de recherche ou un service de facturation.
Le point essentiel est de conserver une frontière explicite. Le domaine exprime ses besoins sous forme de contrats. Les technologies externes s’y branchent en respectant ces contrats, sans imposer leurs propres modèles au cœur de l’application.
Ports, adaptateurs et domaine : les trois pièces à distinguer
Le domaine porte les règles qui ont une valeur métier
Au centre se trouvent les entités, les objets de valeur, les règles de validation et les services métier. Dans une application de réservation, le domaine décide par exemple si une place peut être réservée, si une annulation est encore autorisée ou si un quota est dépassé. Ces décisions ne devraient pas dépendre du fait que la demande arrive par HTTP, par un fichier CSV ou par un message asynchrone.
Le domaine n’a pas besoin de savoir comment une donnée est stockée. Il manipule des concepts métier comme une réservation, un client, un créneau ou une disponibilité. Cette indépendance n’interdit pas l’usage d’un framework. Elle évite que ses annotations, ses conventions et ses objets techniques se mélangent aux règles essentielles.
Les ports décrivent les conversations autorisées
Un port entrant (inbound) décrit ce que l’application sait faire. Il correspond généralement à un cas d’utilisation : créer une réservation, enregistrer un client, annuler une commande ou consulter un solde. Il définit les données attendues, le résultat produit et les règles d’orchestration, sans connaître le canal d’entrée.
Un port sortant (outbound) décrit ce dont l’application a besoin pour accomplir une action : charger une réservation, sauvegarder une commande, envoyer un e-mail ou demander une autorisation de paiement. Le contrat appartient au cœur applicatif, car c’est lui qui formule le besoin. Une interface telle que « rechercher les créneaux disponibles » est plus expressive qu’une dépendance directe à un dépôt SQL particulier.
Les adaptateurs traduisent, sans décider à la place du métier
Les adaptateurs font circuler les données à travers la frontière. Un contrôleur REST traduit une requête HTTP en commande compréhensible par un port entrant. Un adaptateur de persistance transforme une entité métier en enregistrement de base de données. Un adaptateur de messagerie convertit un événement métier dans le format attendu par un broker.
Un bon adaptateur reste volontairement mince. Il gère le protocole, le format, l’authentification ou la sérialisation, puis délègue la décision. Si un contrôleur contient les règles de tarification ou si un dépôt choisit les règles de validation, la frontière perd son intérêt. L’adaptateur devrait traduire l’échange, pas devenir un second domaine.
Visualiser les flux avec un cas de réservation
Imaginons une application qui permet de réserver un créneau de consultation. Un utilisateur soumet un formulaire ; l’application vérifie la disponibilité, enregistre la réservation et confirme l’opération. Dans une architecture hexagonale, le flux peut être organisé ainsi :
- Un adaptateur entrant, par exemple un contrôleur REST, reçoit la requête et en extrait les données utiles.
- Il appelle le port entrant Réserver un créneau.
- Le cas d’utilisation applique les règles métier et demande, via un port sortant, les créneaux déjà occupés.
- Un adaptateur sortant interroge la base de données et renvoie les informations dans une forme adaptée au domaine.
- Après validation, le cas d’utilisation demande la sauvegarde et, si nécessaire, l’envoi d’une confirmation par un autre port sortant.
Le bénéfice concret apparaît lorsqu’un nouveau canal arrive. Une interface mobile, un import nocturne ou une API partenaire peut appeler le même port entrant sans recopier la logique de disponibilité. De même, remplacer le fournisseur d’e-mails ne modifie pas la règle « confirmer une réservation » : seul l’adaptateur de notification change.
On peut voir les ports comme les culées d’un pont : ils fixent les points de passage stables entre deux rives. D’un côté, les protocoles, les écrans, les bases et les fournisseurs évoluent vite. De l’autre, les notions métier doivent conserver leur sens. Plus la partie technique peut être remplacée sans toucher aux contrats, plus l’équipe peut moderniser une API, déplacer un stockage ou introduire une file de messages sans fragiliser les règles de gestion.
Mettre en place le modèle sans surarchitecturer
L’adoption est plus sûre lorsqu’elle part des cas d’utilisation réels plutôt que d’un découpage théorique. Il n’est pas nécessaire de créer une interface pour chaque classe ni de multiplier les modules dès le premier jour. L’enjeu est de rendre visibles les frontières qui comptent, celles qui séparent une règle métier d’une technologie susceptible de changer.
Partir des actions métier et écrire les contrats
Commencez par nommer les opérations offertes par l’application : publier une annonce, valider un panier, affecter une ressource ou clôturer une période. Ces verbes deviennent de bons candidats pour les ports entrants. Identifiez ensuite les dépendances indispensables à leur exécution : persistance, horloge, génération d’identifiant, paiement, stockage de document ou émission d’événement. Elles deviennent des ports sortants.
Les modèles qui franchissent une frontière méritent une attention particulière. Un DTO de requête HTTP n’a pas à traverser directement le domaine : il peut être converti en commande applicative. Cette conversion protège les règles métier des choix de nommage, de validation ou de versionnement propres à l’API. Elle évite aussi que la forme d’une requête externe devienne la forme de référence du domaine.
Tester d’abord le cœur, puis les raccordements
Les tests automatisés gagnent en lisibilité lorsque le cas d’utilisation est exécuté avec de faux adaptateurs : un dépôt en mémoire, une horloge contrôlée ou un émetteur de notification simulé. Le test vérifie alors une règle métier sans démarrer de serveur web ni de base de données. Les adaptateurs réels gardent leurs propres tests d’intégration pour vérifier une requête SQL, un schéma de message ou un appel réseau.
- Gardez les interfaces proches du besoin métier, pas des détails d’un fournisseur.
- Évitez d’exposer des objets d’ORM dans les cas d’utilisation.
- Faites dépendre l’assemblage de l’application du framework, jamais le domaine.
- Introduisez une abstraction lorsqu’elle isole une variabilité réelle, pas par réflexe.
Architecture hexagonale, MVC, couches et DDD : ce qui les distingue
L’architecture hexagonale ne remplace pas nécessairement les autres modèles. Elle répond surtout à la direction des dépendances et à l’isolation du métier. MVC organise principalement une interaction d’interface. L’architecture en couches répartit souvent le code entre présentation, application, domaine et infrastructure. Le Domain-Driven Design (DDD) fournit une approche de modélisation du métier. Ces approches peuvent se compléter.
| Approche | Question principale | Point de vigilance |
|---|---|---|
| Architecture hexagonale | Comment protéger le domaine des acteurs externes ? | Créer des ports inutiles pour de simples détails internes. |
| MVC | Comment séparer l’interface, la présentation et le contrôle ? | Laisser le contrôleur concentrer la logique métier. |
| Architecture en couches | Comment répartir les responsabilités par niveau ? | Faire dépendre le domaine des couches techniques inférieures. |
| DDD | Comment modéliser un domaine métier complexe ? | Confondre stratégie de modélisation et architecture technique. |
DDD et l’architecture hexagonale s’accordent naturellement. Le premier aide à définir un langage métier cohérent, tandis que la seconde protège ce modèle des détails périphériques. En revanche, pour un script court, un prototype jetable ou une application très simple, ce niveau de découplage peut ajouter une complexité disproportionnée. Il devient particulièrement pertinent lorsque les règles métier sont nombreuses, que les intégrations externes se multiplient ou que l’application doit durer.