Une architecture Big Data relie les flux aux décisions, du stockage au reporting
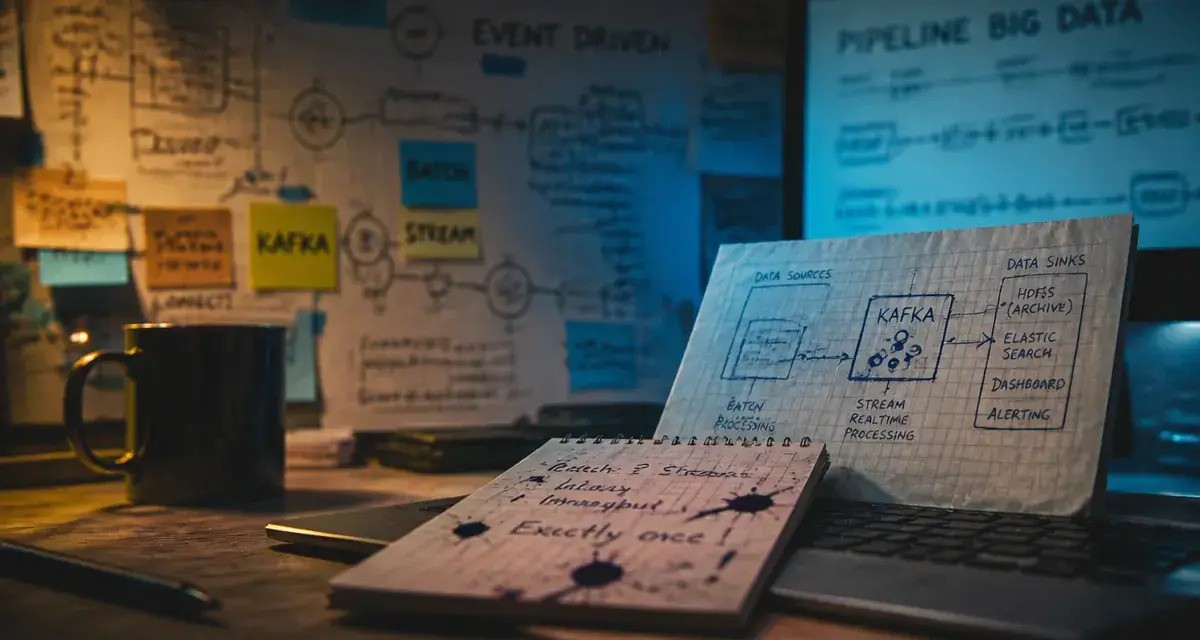
Une architecture Big Data organise le parcours de données trop volumineuses, rapides ou hétérogènes pour être exploitées efficacement dans une base de données traditionnelle. Elle ne sert pas uniquement à stocker des centaines de gigaoctets ou de téraoctets. Elle doit aussi rendre les données fiables, accessibles et utiles pour le reporting, l’analyse métier ou le Machine Learning.
À quoi sert réellement une architecture Big Data ?
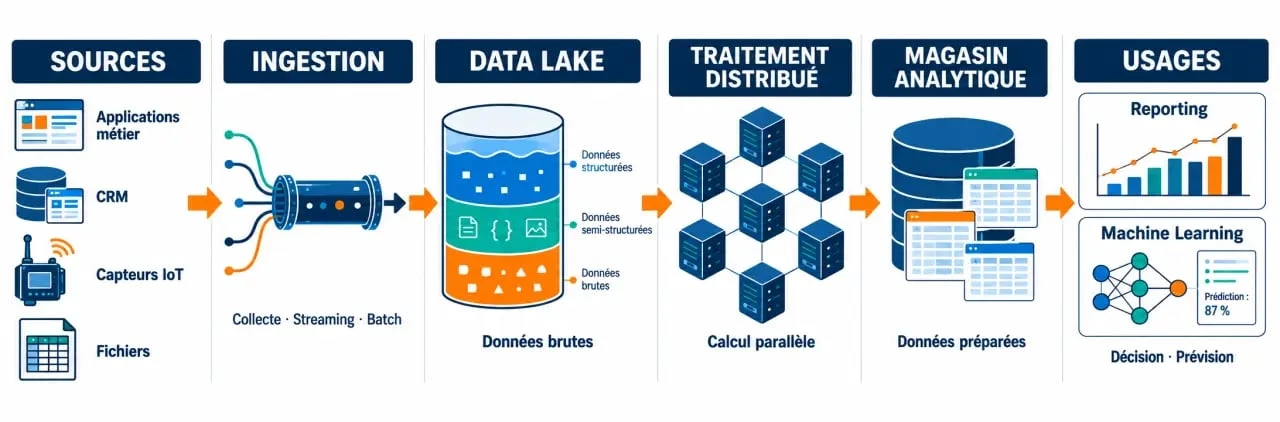
Une architecture Big Data relie des sources multiples à des usages concrets. Elle collecte des données structurées, comme des tables relationnelles, mais aussi des données semi-structurées ou non structurées : fichiers journaux, documents, événements applicatifs, messages clients, images ou mesures issues d’objets IoT. Elle les ingère, les conserve, les transforme, puis les expose aux bonnes personnes ou aux bons systèmes.
Quiz : comprendre l’architecture Big Data
Une base relationnelle classique reste adaptée aux opérations transactionnelles stables et bien structurées. Elle atteint toutefois ses limites lorsque le volume augmente fortement, que les formats se diversifient ou qu’il faut analyser des historiques massifs avec une faible latence. Une architecture distribuée répartit alors le stockage et le calcul sur plusieurs machines, plutôt que de faire évoluer un seul serveur jusqu’à saturation.
Le résultat attendu doit être formulé en termes métier : détecter une fraude pendant qu’elle se produit, consolider les ventes de la veille, suivre une chaîne logistique, personnaliser une recommandation ou entraîner un modèle prédictif. Sans objectif d’usage, accumuler des données dans un data lake ne crée pas de valeur.
Le parcours de la donnée : les briques à assembler
Des sources à l’ingestion, sans créer de goulot d’étranglement
Le flux commence par les sources : applications métier, CRM, ERP, bases NoSQL, fichiers plats, capteurs ou services externes. L’ingestion peut être planifiée, par exemple chaque nuit, ou continue lorsque les événements arrivent en temps réel. Dans ce second cas, un système de messages et une mémoire tampon de flux absorbent les pics de trafic, découplent l’émetteur du consommateur et limitent le risque de perte lors d’un ralentissement en aval.
Des outils comme Apache Kafka, Azure Event Hubs ou Azure IoT Hub peuvent jouer ce rôle. Le choix dépend moins du nom de l’outil que de sa capacité à gérer les volumes, l’ordre des événements, la reprise après incident et la durée de conservation nécessaire pour retraiter un flux.
Stocker, traiter puis servir les usages analytiques
Le stockage brut s’appuie souvent sur un data lake ou sur un magasin de fichiers distribué tel que HDFS. Il conserve les données dans leur format d’origine, ce qui facilite les explorations futures. Un entrepôt de données privilégie au contraire les données structurées et préparées pour les requêtes BI. Le lakehouse cherche à combiner la souplesse du data lake avec des fonctions de gouvernance et de performance analytique.
Après le stockage, les traitements filtrent, dédupliquent, normalisent, enrichissent et agrègent les données. Apache Spark et Spark Streaming conviennent au calcul distribué. Azure Databricks et Microsoft Fabric proposent des environnements intégrés autour de ces besoins. Les données préparées peuvent ensuite alimenter un magasin analytique, une base NoSQL, un entrepôt ou des outils comme Power BI, Excel et Jupyter.
Batch, streaming et exploration : choisir le bon rythme
Le traitement batch exécute des calculs sur un lot de données accumulées. Il convient aux consolidations quotidiennes, aux recalculs historiques et aux traitements qui exigent une vision complète. Il favorise la précision, mais les résultats ne sont disponibles qu’après l’exécution du traitement.
Le traitement de flux traite les événements à mesure qu’ils arrivent. Il est pertinent pour l’alerte, le suivi d’activité, la détection d’anomalies ou les usages où quelques minutes, voire moins, peuvent changer la décision. Il impose cependant de gérer les doublons, les événements tardifs, les changements de schéma et les reprises de traitement.
Entre ces deux temporalités, l’exploration interactive répond à un autre besoin : permettre à un analyste de poser rapidement des questions sur les données disponibles. Elle nécessite des jeux de données préparés, des métadonnées compréhensibles et un moteur analytique adapté, plutôt qu’un accès direct et désordonné à l’ensemble du stockage brut.
Un flux de données se comporte comme une onde : une anomalie initiale peut se propager de l’ingestion au tableau de bord, puis jusque dans les décisions prises par les équipes. Mesurer la fraîcheur des données, le taux de rejets, les retards du pipeline et la dérive des schémas aide à détecter cette perturbation avant qu’elle ne produise une conclusion erronée. Cette observabilité des données doit couvrir chaque passage de relais, pas seulement l’état final d’un rapport.
Lambda, Kappa ou architecture distribuée : quels compromis ?
Ces modèles ne sont pas des obligations. Ils fournissent un cadre pour arbitrer entre latence, complexité d’exploitation, capacité de recalcul et coût. Une architecture distribuée décrit surtout la manière de répartir le stockage et le calcul afin d’obtenir une montée en charge horizontale, une bonne disponibilité et une tolérance aux pannes.
| Modèle | Principe | Atout principal | Point de vigilance | Cas adapté |
|---|---|---|---|---|
| Lambda | Deux chemins : batch et temps réel | Combine historique recalculé et données fraîches | Logique dupliquée, maintenance plus complexe | Indicateurs temps réel nécessitant des corrections historiques |
| Kappa | Un flux continu d’événements, rejouable | Modèle unifié pour le streaming | Rejeu et conservation des événements à maîtriser | Applications centrées sur l’événementiel et la faible latence |
| Distribuée | Calcul et stockage répartis sur plusieurs nœuds | Montée en charge et résilience | Exploitation, réseau et coûts à piloter | Volumes élevés, traitements parallèles, historique important |
L’architecture Lambda reste utile lorsque la rapidité d’un flux temps réel doit être complétée par la précision d’un recalcul batch. L’architecture Kappa convient lorsqu’un même pipeline de streaming peut servir les besoins courants et les retraitements. Dans les deux cas, la décision doit partir de la latence réellement acceptable. Un rapport consulté chaque matin ne justifie pas nécessairement une plateforme de streaming complexe.
Concevoir une architecture durable et exploitable
Partir des contraintes métier avant les technologies
La conception commence par un inventaire : quelles sources seront connectées, qui consommera les résultats, quel historique doit être conservé, quelle fréquence de mise à jour est attendue et quelles données sont sensibles ? Il faut ensuite qualifier les volumes, les pics, les formats, les dépendances entre traitements et les exigences de disponibilité. Cette étape évite de surdimensionner l’infrastructure ou, à l’inverse, de choisir un outil incapable d’absorber la croissance.
- Définir les indicateurs métier, les utilisateurs et le niveau de fraîcheur attendu.
- Profiler les sources pour identifier les formats, les doublons, les valeurs manquantes et les données personnelles.
- Choisir séparément l’ingestion, le stockage, le calcul et la restitution afin de préserver l’évolutivité.
- Prévoir le partitionnement, la réplication et la reprise après incident dès la conception.
- Tester les charges réelles avant de généraliser une solution.
Gouverner, sécuriser et maîtriser les coûts dans la durée
La sécurité des données ne doit pas être ajoutée après coup. Chiffrement, contrôle des accès, séparation des environnements, journalisation et règles de conservation doivent s’appliquer dès l’ingestion. Un catalogue de données et un lignage clair permettent de savoir d’où vient une mesure, quelles transformations elle a subies et qui en est responsable.
La qualité exige des contrôles automatisés : schémas attendus, seuils de complétude, détection des doublons et alertes sur les retards. L’orchestration, avec des solutions comme Azure Data Factory ou Apache Oozie, planifie les dépendances, relance les tâches et publie les résultats au bon moment. Le coût total dépend du stockage, mais aussi du calcul, des transferts, des requêtes et de la conservation des flux. Une pratique FinOps data consiste à suivre ces postes, à arrêter les ressources inutilisées et à adapter les niveaux de stockage à la valeur réelle des données.
Le rôle de l’architecte Big Data dans le projet
L’architecte Big Data traduit les objectifs métier en choix techniques cohérents. Il travaille avec les data engineers sur les pipelines, avec les analystes et data scientists sur les usages, avec les équipes de sécurité sur les accès et avec les responsables métiers sur les priorités. Sa mission consiste à maintenir l’équilibre entre performance, fiabilité, conformité, maintenabilité et budget.
Ses compétences couvrent les systèmes distribués, le cloud ou les environnements hybrides, le stockage, les bases NoSQL, le traitement parallèle, l’orchestration et la gouvernance. Il ne choisit pas nécessairement une solution unique. Une architecture solide peut associer un data lake, un magasin analytique et des services spécialisés, à condition que les interfaces, les responsabilités et les règles de qualité soient explicites. Cette cohérence opérationnelle transforme un empilement d’outils en plateforme de données utile.
- Une architecture Big Data relie les flux aux décisions, du stockage au reporting - 28 septembre 2026
- La programmation orientée objet en Python structure le code sans l’alourdir - 27 septembre 2026
- Formation DevOps : maîtriser Linux, l’automatisation et la pratique avant les certifications - 26 septembre 2026
Partager cet article
Articles qui pourraient vous intéresser :
 Audit sécurité site internet : scan, pentest et remédiation, les trois niveaux à distinguer
 Cybercriminalité : 40 % de hausse et 3 réflexes pour sécuriser vos données
 Solution GED open source : le code est libre, l’exploitation ne l’est pas
 Une base de données se comprend mieux avec trois exemples de tables et de relations