Automatisation des tests : accélérer les livraisons sans multiplier les scripts fragiles
L’automatisation des tests consiste à confier à des outils l’exécution de vérifications logicielles répétables. Elle permet de détecter plus tôt les régressions et de réduire les contrôles manuels récurrents. Pour en tirer profit, il faut toutefois choisir les bons scénarios, disposer de données fiables et prévoir la maintenance dès le départ : automatiser davantage ne signifie pas automatiquement mieux tester.
Des vérifications répétables, pas un remplacement du jugement humain
Un test automatisé prépare une situation, exécute une action et compare le résultat obtenu au résultat attendu. Par exemple, il peut créer un panier, appliquer une réduction et vérifier le montant final. Un script décrit les opérations ; un framework organise leur exécution et les assertions ; les rapports rendent les résultats exploitables.
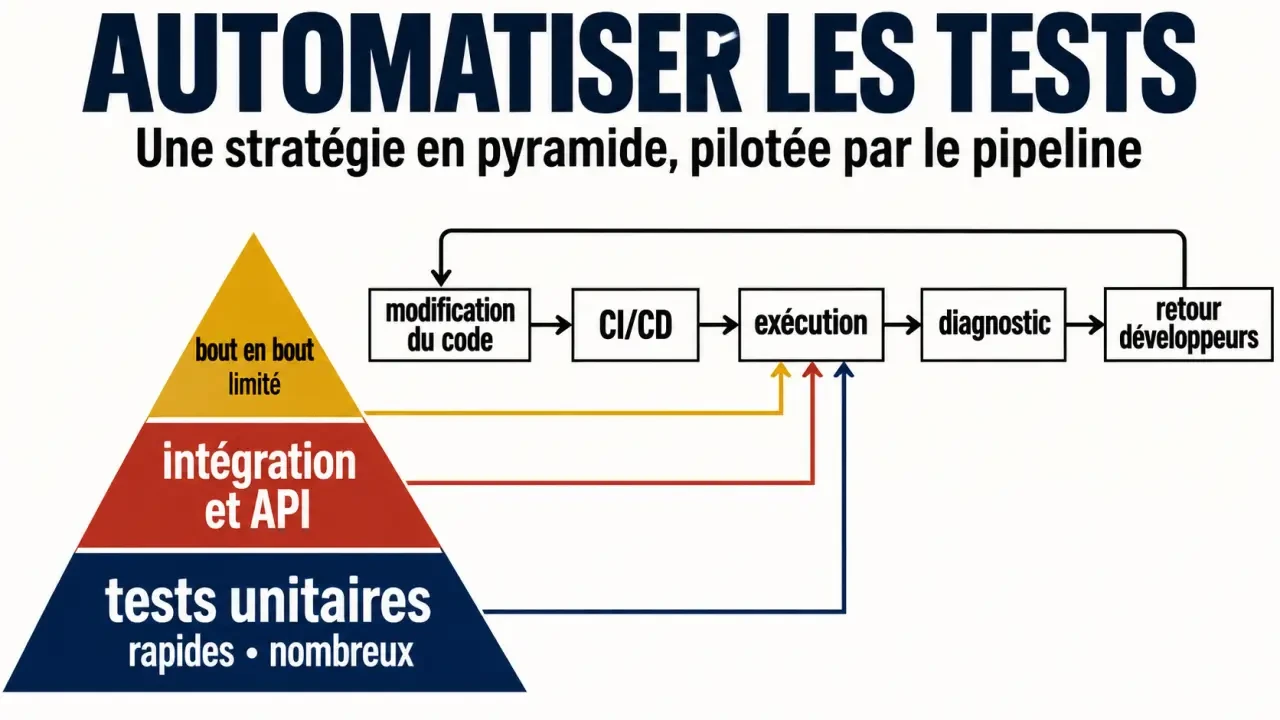
Contrairement au test manuel, chaque exécution ne nécessite pas de reproduire les actions à la main. Cette répétabilité est particulièrement utile pour les tests de régression, qui vérifient qu’une modification n’a pas dégradé un comportement existant. Elle facilite les livraisons fréquentes en Agile et le retour rapide aux développeurs dans une démarche DevOps.
Un test réussi confirme uniquement ce qu’il vérifie explicitement. Il ne prouve pas que le produit est exempt de défauts. Un calcul peut être exact alors que son affichage reste incompréhensible pour l’utilisateur.
Les tests exploratoires conservent donc une place essentielle : une personne adapte ses investigations aux anomalies rencontrées, interroge les usages et repère des incohérences non anticipées. L’évaluation du confort d’utilisation, certaines interactions physiques ou des scénarios difficiles à reproduire peuvent également justifier une intervention manuelle.
Choisir le bon niveau avant d’automatiser un parcours
La pyramide de test recommande une base importante de tests rapides et ciblés, complétée par des vérifications d’intégration puis par un nombre plus limité de parcours complets. Ce modèle guide les arbitrages ; il n’impose pas une répartition universelle.
| Niveau ou famille | Ce que le test vérifie | Point de vigilance |
|---|---|---|
| Unitaire | Une fonction ou un module isolé, comme un calcul de remise. | Des dépendances simulées peuvent masquer un problème d’intégration. |
| Intégration et API | La coopération des composants et les réponses des services. | Les contrats, données et dépendances doivent être maîtrisés. |
| Bout en bout | Un parcours complet, comme une commande depuis l’interface. | L’exécution et le diagnostic sont souvent plus coûteux. |
| Performance, sécurité, accessibilité | Des propriétés techniques et des règles spécifiques. | Les contrôles automatisés ne remplacent pas toutes les analyses spécialisées. |
Ces catégories se croisent : un test fonctionnel vérifie une exigence, tandis qu’un test de régression désigne une finalité. Tous deux peuvent s’appuyer sur des tests unitaires, des API ou une interface utilisateur.
Pour une règle de tarification, privilégiez des tests unitaires couvrant les cas limites. Vérifiez ensuite par API que le service applique cette règle, puis conservez un parcours d’achat complet pour contrôler l’assemblage. Répéter toutes les variantes par l’interface alourdirait inutilement la suite.
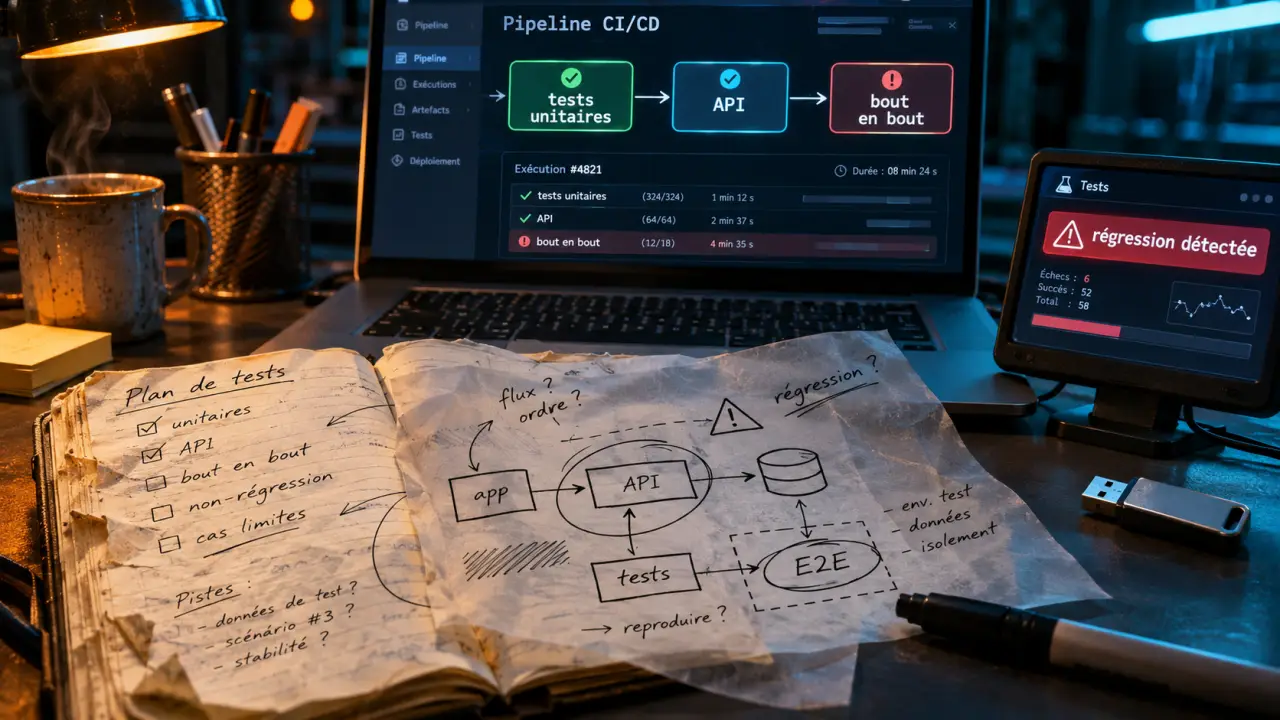
Une modification se propage parfois comme une vague : un changement dans un service partagé déclenche des échecs dans plusieurs parcours. Pour éviter de traiter chaque symptôme séparément, associez les tests aux composants qu’ils sollicitent et recherchez le premier point de rupture commun. Cette cartographie des dépendances rend les rapports plus utiles qu’une simple accumulation de voyants rouges.
Prioriser selon le risque, la répétition et le coût réel
Commencez par les comportements dont la défaillance aurait un impact important et qui sont vérifiés régulièrement. Une authentification, un paiement ou une règle de droits constituent souvent de meilleurs candidats qu’un écran secondaire en pleine refonte.
Wefiit cite la règle 20/80, selon laquelle 20 % des fonctionnalités représenteraient 80 % des fonctionnalités utilisées. Prenez-la comme une invitation à examiner les usages réels, et non comme une répartition garantie pour votre application. Une fonction rarement utilisée peut rester critique, par exemple pour la restauration de données.
- Fréquence : le scénario est-il rejoué à chaque livraison ou seulement exceptionnellement ?
- Criticité : quel serait l’impact d’un défaut sur l’activité, les utilisateurs ou les données ?
- Stabilité : le comportement attendu et les interfaces sont-ils suffisamment définis ?
- Faisabilité : les données et dépendances nécessaires sont-elles contrôlables ?
- Maintenance : les changements prévisibles risquent-ils d’imposer des reprises fréquentes ?
Pour évaluer la rentabilité, comparez sur une période définie le temps des exécutions manuelles évitées au temps de conception, d’exploitation, d’analyse et de maintenance. Ajoutez les licences et l’infrastructure. La valeur des défauts détectés compte également, mais évitez de lui attribuer un montant arbitraire.
Un premier lot limité permet de mesurer ces coûts avant d’étendre la démarche. Si sa maintenance absorbe les économies attendues, revoyez le niveau de test, la stabilité du périmètre ou la préparation des données plutôt que de multiplier les scripts.
Évaluer les outils sur un scénario réel, puis organiser le pipeline
Le choix d’un outil doit partir de la stack et des compétences de l’équipe. Une solution facile à prendre en main peut devenir contraignante lorsqu’il faut déboguer une dépendance complexe. À l’inverse, un framework très flexible peut demander un investissement technique disproportionné.
Comparer au-delà de la démonstration
Les frameworks pilotés par du code offrent de la souplesse, mais demandent des compétences en programmation. Les approches low-code ou no-code, dont Mabl est un exemple, peuvent faciliter la contribution de profils moins techniques ; elles ne suppriment ni la conception des scénarios ni leur maintenance.
Testez chaque solution sur le même parcours représentatif : création du test, modification d’un écran, diagnostic d’un échec et exécution dans votre CI/CD. Examinez la compatibilité avec vos environnements, la lisibilité des rapports, la gestion des secrets, l’exécution parallèle, les coûts et les possibilités de versionnement.
Faire remonter les erreurs au bon moment
Dans le pipeline, lancez d’abord les tests unitaires rapides, puis les contrôles d’intégration et d’API. Réservez les parcours complets indispensables aux étapes où ils apportent un signal utile. Les campagnes plus longues peuvent être planifiées séparément, selon les risques et les délais acceptables.
Préparez des environnements reproductibles, des comptes dédiés et des jeux de données synthétiques ou correctement anonymisés. Chaque test doit pouvoir préparer puis nettoyer son état sans dépendre du passage du précédent.
Les développeurs contribuent aux tests proches du code ; les testeurs et responsables QA structurent les scénarios et l’analyse des risques. Le Product Owner clarifie les comportements attendus, tandis que les équipes DevOps facilitent l’exécution et l’observation. Chaque suite doit avoir un responsable de maintenance identifié.
Mesurer la confiance obtenue, pas seulement le nombre de tests
Un tableau de bord utile suit la durée jusqu’au premier retour exploitable, les défauts détectés, les régressions arrivées en production et le temps consacré à la maintenance. Examinez aussi la couverture des risques métier, pas uniquement le volume de scripts.
Atlassian évoque une couverture de code proche de 100 % comme objectif dans certains scénarios. Ce chiffre n’est pas une cible universelle : exécuter une ligne ne garantit pas qu’une assertion pertinente contrôle son résultat. Une suite volumineuse peut laisser un comportement critique sans protection.
Surveillez les tests flaky, dont le résultat varie sans changement pertinent du produit. Recherchez les attentes temporelles mal gérées, les données partagées et les dépendances externes instables. Relancer automatiquement peut aider au diagnostic, mais ne constitue pas une correction.
Isolez temporairement un test instable si nécessaire, avec un responsable et une échéance de réparation. Supprimez également les contrôles obsolètes ou redondants. Une automatisation efficace produit des résultats auxquels l’équipe fait confiance et qu’elle peut comprendre rapidement : c’est cette confiance, davantage que l’accumulation de tests, qui sécurise les livraisons.
- Automatisation des tests : accélérer les livraisons sans multiplier les scripts fragiles - 15 novembre 2026
- Mantra cybersécurité : du phishing simulé aux alertes dans vos outils de travail - 14 novembre 2026
- Développement web et dispositifs interactifs : du code aux expériences immersives en BUT MMI - 13 novembre 2026