ETL vs ELT : faut-il charger vite ou contrôler les données avant l’entrepôt ?
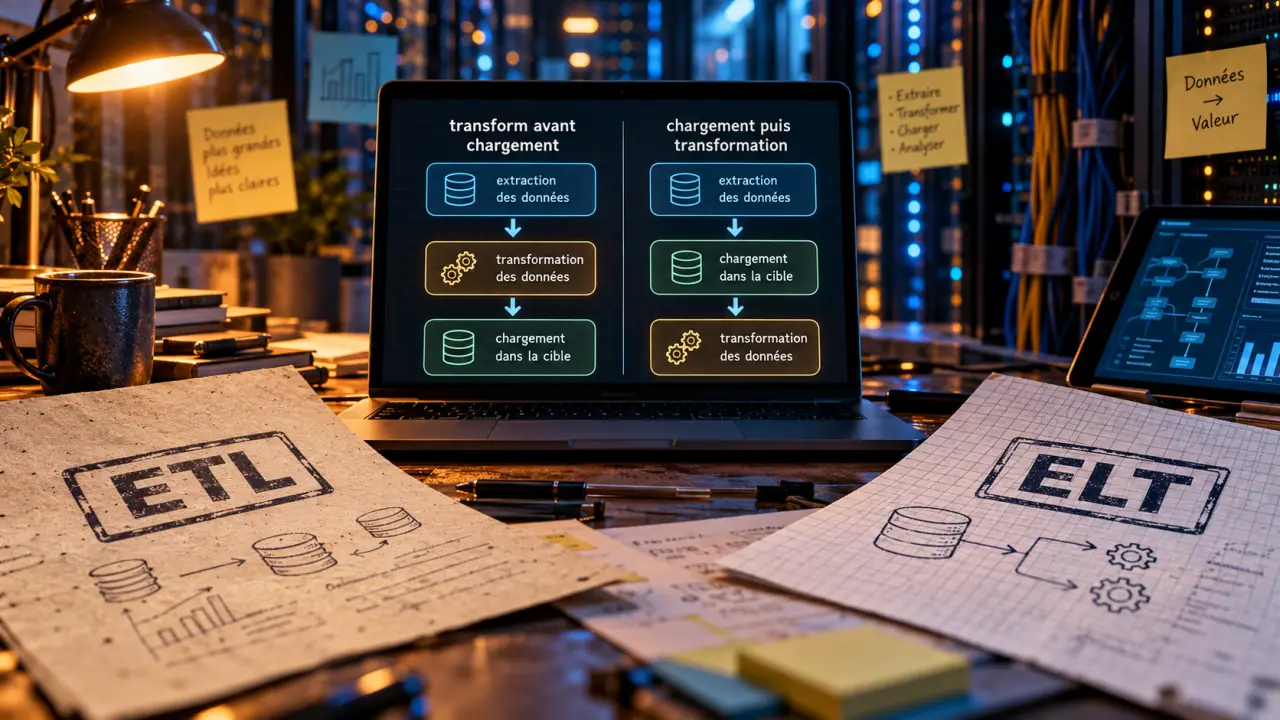
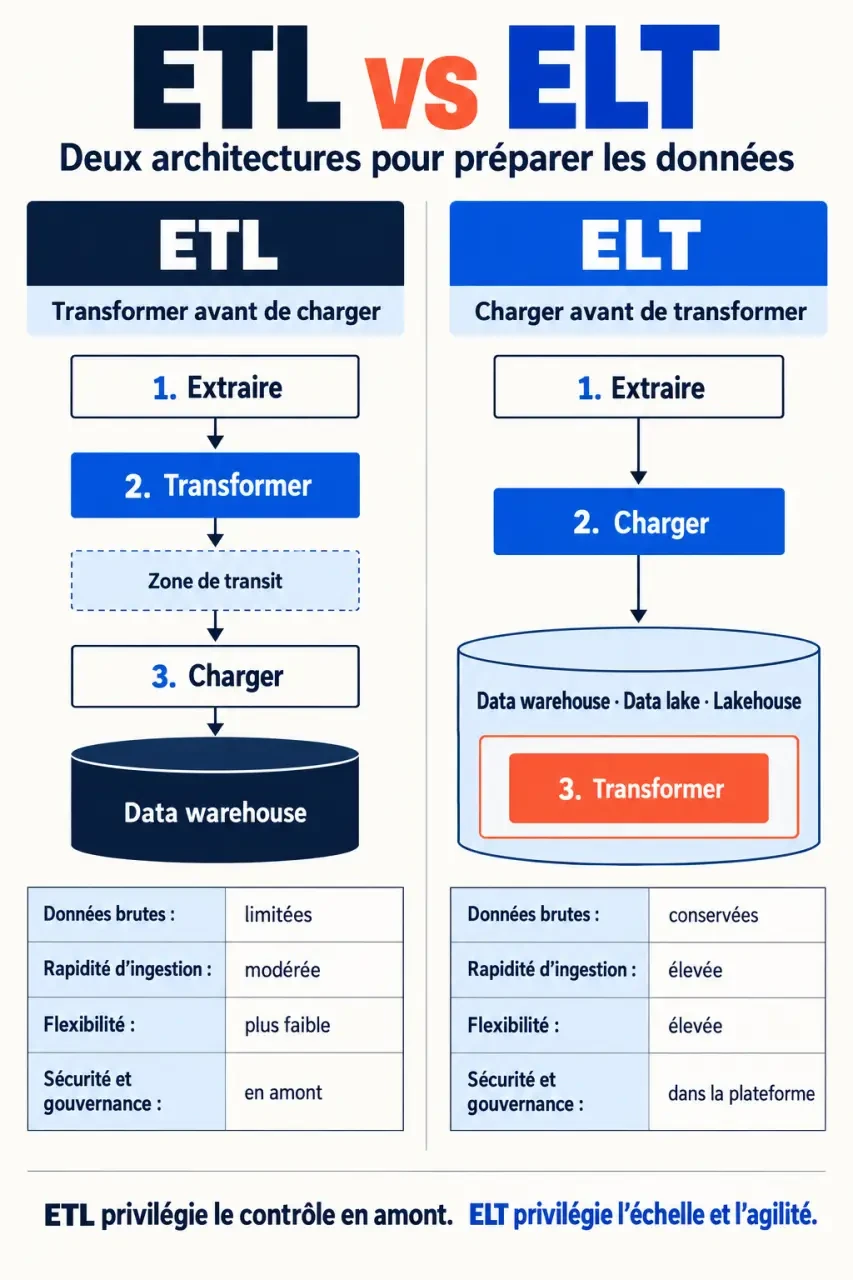
ETL et ELT répondent au même besoin : intégrer des données issues de sources hétérogènes pour les rendre utilisables en reporting, en analytique, en intelligence artificielle ou en machine learning. La différence tient à l’ordre des opérations. Avec l’ETL, les données sont transformées avant leur chargement dans la cible. Avec l’ELT, elles sont chargées d’abord, puis transformées dans le système cible. Ce choix influence la rapidité, la flexibilité, la sécurité et la maintenance du pipeline.
ETL et ELT : le même objectif, un ordre d’exécution différent
Les deux approches peuvent intégrer des données provenant de bases relationnelles ou NoSQL, de CRM, d’ERP, d’API, de fichiers, de journaux applicatifs, de flux d’événements ou de capteurs. Elles organisent ensuite ces informations pour les rendre exploitables par les équipes data et métier.
ETL : Extract, Transform, Load
Un pipeline ETL extrait les données depuis les systèmes sources, les transforme dans un outil dédié ou une zone de transit, puis les charge dans le système cible. Les transformations peuvent comprendre le nettoyage, la normalisation, le filtrage, la déduplication, l’agrégation, la validation, le calcul de champs métier, le masquage ou la conversion d’unités.
Le chargement intervient lorsque les données respectent déjà le schéma attendu par l’entrepôt ou la base cible. L’ETL convient donc aux données structurées, aux modèles stables et aux environnements où la qualité ou la confidentialité doivent être traitées avant l’arrivée dans le système analytique. Les équipes disposent ainsi de tables déjà préparées pour les rapports et les analyses.
ELT : Extract, Load, Transform
Avec ELT, les données sont extraites puis chargées, souvent à l’état brut, dans un entrepôt de données cloud, un data lake ou un data lakehouse. La transformation intervient ensuite dans ce système cible, généralement avec SQL et des outils tels que dbt.
L’ELT exploite les capacités de stockage et de calcul de la plateforme cible. Cette approche devient intéressante lorsque les sources changent souvent, que les volumes sont importants ou que plusieurs équipes doivent appliquer des règles différentes à une même matière première. La conservation des données brutes permet aussi de revoir une transformation sans refaire l’extraction depuis la source.
ETL vs ELT : les critères qui changent réellement la décision
| Critère | ETL | ELT |
|---|---|---|
| Ordre des étapes | Extraction, transformation, chargement | Extraction, chargement, transformation |
| Lieu de transformation | Zone de transit ou outil externe | Système cible |
| Vitesse d’ingestion | Peut être ralentie par les traitements préalables | Souvent élevée grâce au chargement des données brutes |
| Types de données | Principalement structurées et schématisées | Structurées, semi-structurées et non structurées |
| Flexibilité | Résultat maîtrisé, mais logique plus figée | Réutilisation plus facile des données brutes |
| Sécurité | Protection possible avant le chargement | Gouvernance renforcée nécessaire dans la cible |
| Coûts et maintenance | Ressources dédiées de transformation à administrer | Coût de calcul dépendant de l’usage du système cible |
L’ETL privilégie la préparation en amont. Les utilisateurs reçoivent des tables nettoyées et adaptées à un besoin défini. L’ELT privilégie la conservation des données brutes et l’itération. Les équipes peuvent créer de nouveaux modèles, modifier une règle métier ou répondre à une question apparue après l’ingestion.
La comparaison ne revient pas à opposer une méthode ancienne à une méthode moderne. Un ETL mal dimensionné peut devenir lent et difficile à faire évoluer. Un ELT dépourvu de règles d’accès, de catalogue ou de contrôles qualité peut transformer le système cible en espace difficile à comprendre. Le choix dépend du niveau de contrôle attendu à chaque étape du pipeline.
Quelle approche pour un data warehouse, un data lake ou un lakehouse ?
Data warehouse : données prêtes à analyser ou transformation dans l’entrepôt
Le data warehouse traditionnel est historiquement associé à l’ETL. Les données y arrivent conformes à un schéma prédéfini, prêtes pour les tableaux de bord et les analyses OLAP. Cette organisation reste pertinente pour les rapports financiers, les indicateurs réglementés ou les référentiels métier dont les règles sont clairement établies.
Les entrepôts cloud modernes, tels qu’Amazon Redshift, Google BigQuery ou Snowflake, peuvent aussi accueillir des flux ELT. Le chargement rapide est suivi de transformations SQL dans l’entrepôt. Les sources deviennent ainsi disponibles plus tôt, tandis que les analystes disposent d’une plus grande autonomie pour construire les modèles dont ils ont besoin.
Data lake et data lakehouse : l’ELT s’intègre naturellement
Un data lake stocke des fichiers et des données de formats variés. L’ELT correspond à cette logique : les données brutes sont conservées, puis un schéma en lecture est appliqué selon l’usage envisagé. Cette organisation convient aux journaux, aux événements, aux données IoT, aux contenus semi-structurés et aux projets d’IA.
Le data lakehouse combine les possibilités du data lake et du data warehouse. Il peut héberger des pipelines ELT pour l’exploration et des flux ETL pour les jeux de données certifiés. Cette coexistence permet d’adapter la méthode au niveau de contrôle requis, sans imposer une seule architecture à tous les usages.
Sécurité, qualité et gouvernance : le point de bascule souvent sous-estimé
Dans un ETL, les données personnelles ou confidentielles peuvent être filtrées, chiffrées ou masquées avant leur chargement final. L’exposition est alors limitée dans le système analytique. En contrepartie, ces règles doivent être maintenues dans la zone de transit et testées à chaque évolution de la source.
Dans un ELT, le chargement des données brutes impose de sécuriser rapidement le stockage cible. Cela passe par l’authentification, le chiffrement, des droits d’accès granulaires, la rétention, l’audit et la traçabilité. Il faut aussi documenter le data lineage, c’est-à-dire le parcours d’une donnée depuis sa source jusqu’à une table ou un indicateur final.
La fiabilité d’un pipeline dépend de chaque étape. Une règle de déduplication, un contrôle de schéma, un horodatage d’ingestion ou une alerte sur les échecs peuvent sembler limités pris séparément. Ensemble, ils évitent qu’une donnée erronée se propage silencieusement dans les rapports, les modèles de prévision et les décisions métier.
La qualité ne se résume donc pas au nettoyage. Elle comprend aussi la fraîcheur des données, la complétude, l’unicité, la cohérence des formats et la capacité à expliquer une anomalie. Ces contrôles peuvent être mis en place en ETL comme en ELT. Ils doivent toutefois être orchestrés, suivis et confiés à des responsables identifiés.
Choisir entre ETL et ELT : une méthode de décision concrète
Commencez par qualifier les contraintes plutôt que par sélectionner un outil. Une architecture pertinente doit correspondre au flux réel des données, aux usages aval, à l’infrastructure disponible et à la maturité des équipes data.
- Privilégiez l’ETL si les données sont majoritairement structurées, si le schéma cible est stable, si les règles de qualité sont connues et si des données sensibles doivent être protégées avant le chargement.
- Privilégiez l’ELT si vous ingérez de grands volumes, des formats variés ou des sources qui changent fréquemment, et si la cible dispose de capacités de calcul adaptées.
- Choisissez une approche hybride si certains flux exigent un masquage ou une validation stricte en amont, tandis que d’autres doivent être chargés rapidement pour l’exploration ou l’IA.
- Évaluez la fréquence : un traitement quotidien par lots n’impose pas les mêmes choix qu’un flux d’événements quasi temps réel.
- Anticipez l’exploitation : orchestration, reprise sur erreur, gestion des changements de schéma et surveillance des coûts doivent être prévus dès la conception.
En pratique, l’ETL apporte un cadre fort et des données normalisées dès leur arrivée. L’ELT apporte une ingestion rapide et une plus grande liberté d’analyse. L’enjeu est d’aligner le lieu de transformation sur les impératifs de conformité, les capacités techniques et la vitesse à laquelle les besoins métier évoluent.
Partager cet article
Articles qui pourraient vous intéresser :
 GRC en cybersécurité : gouvernance, risque et conformité pour piloter la sécurité
 Solution GED open source : le code est libre, l’exploitation ne l’est pas
 Une base de données se comprend mieux avec trois exemples de tables et de relations
 MDR en cybersécurité : transformer les alertes en décisions et en actions