Logiciel de gestion des correctifs en entreprise : automatiser sans perdre le contrôle
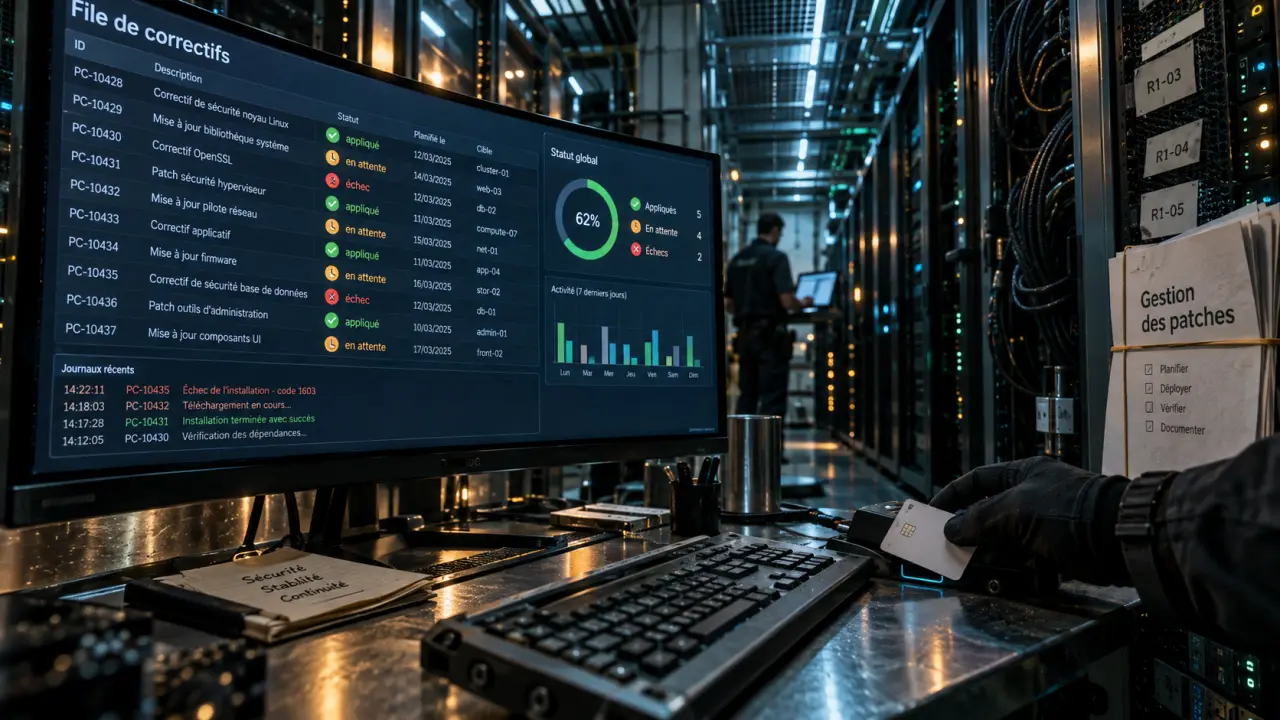
Un parc informatique non corrigé expose l’entreprise aux vulnérabilités, aux interruptions imprévues et aux difficultés d’audit. Pour une DSI, le bon outil doit détecter les mises à jour manquantes, orchestrer leur installation sur les postes et les serveurs, puis montrer clairement ce qui a été appliqué, différé ou a échoué. L’objectif est simple : automatiser le déploiement sans perdre la maîtrise des opérations.
Ce qu’un outil de patch management doit réellement couvrir
Un logiciel de gestion des correctifs en entreprise centralise le cycle de vie des mises à jour depuis une console unique : inventaire des équipements, détection des correctifs disponibles, évaluation de leur priorité, approbation, déploiement et reporting. Il évite aux équipes IT de suivre manuellement les versions installées sur chaque endpoint, notamment dans les environnements multisites ou hybrides.
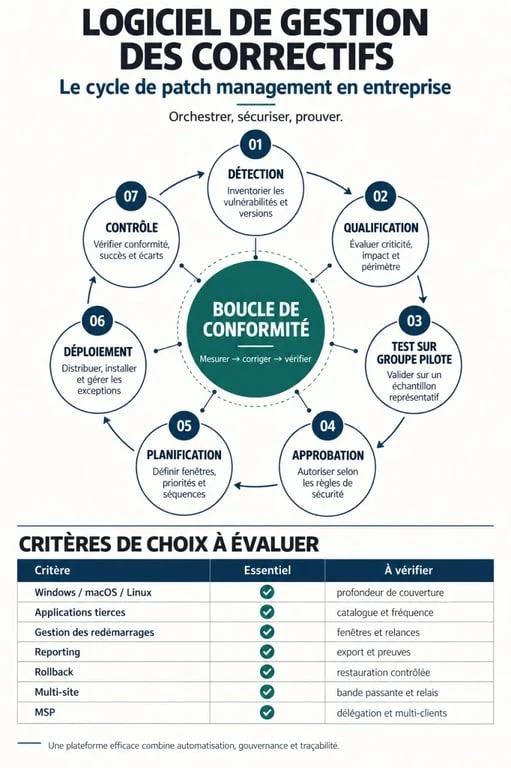
La couverture attendue dépasse les mises à jour du système d’exploitation. Une faille peut aussi provenir d’un navigateur, d’un lecteur PDF, d’un outil de visioconférence ou d’une autre application tierce. Il faut donc distinguer la gestion des correctifs pour Windows, macOS et Linux de celle des logiciels métiers et des utilitaires. Certains éditeurs sont particulièrement solides sur l’écosystème Microsoft. D’autres privilégient une approche réellement multiplateforme ou une large bibliothèque d’applications tierces. Ce périmètre doit être vérifié avant toute comparaison.
La centralisation ne suffit pas sans visibilité exploitable
Une console unique est utile si elle transforme des milliers d’informations techniques en décisions opérationnelles. Le tableau de bord doit faire ressortir les terminaux non conformes, les correctifs critiques non installés, les machines hors ligne et les erreurs de déploiement. Une liste brute de mises à jour ne permet pas à une équipe de sécurité de prioriser les actions.
Un tableau de bord efficace montre le niveau de discipline opérationnelle de l’entreprise. Il révèle parfois un écart discret, mais important : les postes du siège sont à jour, tandis que les ordinateurs nomades, les succursales ou les serveurs rarement redémarrés accumulent les exceptions. Une lecture par zones, groupes et usages aide à corriger ces angles morts avant qu’ils ne deviennent un incident de sécurité. La visibilité par groupe compte donc autant que la présence d’une console centralisée.
Automatiser le déploiement tout en protégeant la continuité de service
L’automatisation ne signifie pas l’installation immédiate de tous les correctifs sur tous les équipements. Une politique efficace repose sur des règles adaptées à la criticité, au type de machine et à la stabilité connue de la mise à jour. Les postes bureautiques, les serveurs de production et les appareils de télétravail n’ont ni les mêmes contraintes ni les mêmes fenêtres de maintenance.
Un cycle de déploiement en plusieurs étapes
- Détecter les correctifs manquants et identifier les versions concernées.
- Qualifier les mises à jour selon leur criticité, leur impact potentiel et les dépendances applicatives.
- Tester sur un groupe pilote représentatif avant une diffusion plus large.
- Approuver ou différer selon des règles automatiques et une validation humaine pour les cas sensibles.
- Planifier le déploiement pendant une fenêtre de maintenance adaptée.
- Contrôler les résultats, les redémarrages et les éventuels échecs.
Les scripts pré- et post-patch sont utiles lorsqu’une application doit être arrêtée proprement, qu’un service doit être relancé ou qu’un contrôle spécifique doit être exécuté après l’installation. Pour les serveurs critiques, la possibilité de déclencher une sauvegarde, un snapshot ou un mécanisme de rollback avant la mise à jour réduit le risque opérationnel. Cette précaution ne remplace pas les tests, mais elle offre une solution de repli lorsqu’un correctif provoque une instabilité.
Les redémarrages sont une politique, pas un détail technique
Un redémarrage imposé en pleine activité peut coûter plus cher qu’un correctif différé de quelques heures. Le logiciel retenu doit permettre de notifier l’utilisateur, de reporter l’opération dans certaines limites, d’imposer un redémarrage si nécessaire et d’appliquer des règles distinctes par groupe d’équipements. Vérifiez aussi le comportement des postes hors ligne : ils doivent recevoir les correctifs à leur reconnexion, sans perdre leur affectation ni échapper durablement au suivi.
La gestion des redémarrages doit également apparaître dans les rapports. Une mise à jour installée, mais en attente de redémarrage, ne produit pas toujours le même niveau de conformité qu’un poste complètement à jour. Cette distinction aide l’équipe IT à traiter les appareils qui nécessitent une action supplémentaire, sans confondre installation et mise en conformité effective.
Comparer les solutions selon votre environnement, pas selon une liste de fonctions
Les offres de patch management se ressemblent souvent dans leurs promesses d’automatisation. La différence se joue plutôt sur la profondeur de couverture, l’intégration avec les outils existants et la facilité de pilotage au quotidien. Une solution pertinente pour une équipe interne de taille moyenne ne répond pas forcément aux besoins d’un prestataire qui gère plusieurs clients. Le choix doit partir du parc réel et des processus existants, pas d’une accumulation de fonctionnalités.
| Contexte | Priorités de sélection | Points de vigilance |
|---|---|---|
| Environnement majoritairement Windows | Intégration WSUS, SCCM ou Intune, gestion des postes et serveurs, règles d’approbation | La couverture macOS, Linux et des applications tierces peut être limitée |
| Parc multi-OS et multisite | Console centralisée, agent fiable, prise en charge de Windows, macOS et Linux, déploiement distant | Vérifier la cohérence des fonctions selon chaque système d’exploitation |
| Applications tierces nombreuses | Catalogue de logiciels couverts, détection des versions, priorisation des correctifs éditeurs | Ne pas supposer que tous les logiciels métiers sont pris en charge |
| MSP ou infogérance | Architecture multi-tenant, délégation des droits, vues par client, intégration RMM et PSA | Contrôler l’isolation des tenants et la qualité du reporting client |
| Exigences d’audit élevées | Historique détaillé, exports, rapports programmés, preuves d’exécution et gestion des exceptions | Un indicateur global de conformité ne remplace pas une traçabilité exploitable |
Des plateformes telles que NinjaOne, ManageEngine, SolarWinds, Kaseya, Atera, N-able, PDQ Deploy ou Patch My PC peuvent entrer dans une présélection selon le périmètre recherché. Le choix ne doit toutefois pas reposer sur le nom de l’éditeur. Demandez une démonstration sur un échantillon représentatif de votre parc, avec vos systèmes, vos contraintes réseau et quelques applications prioritaires.
Cette démonstration doit inclure les cas qui posent généralement problème : un poste distant, un serveur indisponible, une application tierce non référencée ou un correctif qui exige plusieurs redémarrages. Vous pourrez ainsi observer la différence entre une fonction annoncée et une fonction réellement exploitable par l’équipe.
Les critères à vérifier avant de signer
Une démonstration commerciale montre généralement le scénario idéal. Pour évaluer une solution, il faut aussi examiner les exceptions : serveur indisponible, agent déconnecté, correctif échoué, poste sans droits locaux, application incompatible ou mise à jour nécessitant plusieurs redémarrages. La qualité d’un outil apparaît dans sa capacité à rendre ces situations visibles et traitables sans multiplier les manipulations manuelles.
Exigez des preuves de conformité précises
Le reporting doit permettre de répondre rapidement à des questions concrètes : quels endpoints restent vulnérables ? Quel correctif a été installé, sur quelle machine et à quelle date ? Pourquoi une mise à jour a-t-elle été exclue ? Quels appareils sont hors ligne depuis trop longtemps ? Des rapports automatisés, filtrables par site, groupe, système ou niveau de criticité, facilitent les audits et les échanges entre IT, sécurité et direction.
Vérifiez aussi la façon dont l’outil gère les exceptions. Une exclusion temporaire doit avoir une raison, une portée et, si nécessaire, une date de réexamen. Sans ces informations, l’indicateur de conformité peut donner une vision trop générale de la situation. La traçabilité des décisions est indispensable pour expliquer pourquoi un correctif n’a pas été déployé sur une machine donnée.
Évaluez l’intégration et la charge d’exploitation
Un outil isolé crée rapidement une nouvelle tâche administrative. Analysez les intégrations nécessaires avec votre RMM, votre PSA, votre gestion des identités, WSUS, SCCM ou Intune. Vérifiez également le poids de l’agent, les prérequis réseau, les droits requis, la granularité des rôles et la simplicité de création des groupes dynamiques. Une solution moins riche sur le papier, mais bien intégrée, peut produire davantage de valeur qu’une plateforme très complète et difficile à exploiter.
- Testez un déploiement pilote sur des postes, des serveurs et des utilisateurs distants.
- Demandez la liste exacte des systèmes d’exploitation et des applications tierces pris en charge.
- Vérifiez les options de sauvegarde, de snapshot et de retour arrière.
- Mesurez la lisibilité des rapports pour un audit non technique.
- Clarifiez le modèle de licences, notamment pour les serveurs, les appareils mobiles ou les tenants MSP.
Le bon investissement réduit à la fois le délai d’exposition aux correctifs critiques et le volume d’exceptions à gérer. Avant le déploiement global, définissez une politique de patch management claire : groupes pilotes, délais par criticité, fenêtres de maintenance, responsables d’approbation et procédure d’escalade. Le logiciel devient alors un outil de gouvernance et de suivi, plutôt qu’un simple distributeur de mises à jour.
- Logiciel de gestion des correctifs en entreprise : automatiser sans perdre le contrôle - 13 septembre 2026
- Software middleware : la couche qui simplifie l’intégration des systèmes - 12 septembre 2026
- Agent autonome IA : gagner en efficacité sans perdre le contrôle - 11 septembre 2026
Partager cet article
Articles qui pourraient vous intéresser :
 Quels KPI de sécurité informatique suivre pour piloter risques, SLA et budget ?
 Installer Rust avec rustup : la méthode selon Windows, WSL, Linux et macOS
 Graphisme Python : matplotlib pour les courbes, Tkinter pour les fenêtres, Qt pour aller plus loin
 Plateformes IoT cloud, open source ou industrielles : le bon choix selon le projet